M2 Pro Mac mini 32GBでQwen3 8B・14Bを実測|ローカルLLMにハイスペックMacは必要?
M2 Pro・32GBのMac miniでQwen3 8Bと14BをOllamaで実測。生成速度は8Bが約31.5 tok/s、14Bが約14.8 tok/s。ローカルLLMに必要なMacスペックを実際の使用感から検証します。
この記事で分かること
- M2 Pro Mac mini 32GBでQwen3 8B・14Bを動かした実測結果
- 8Bを普段使い、必要に応じて14Bへ切り替える運用感
- ローカルLLM用Macを用途から逆算して選ぶ考え方
M2 Pro Mac mini 32GBで、Qwen3 8BとQwen3 14BをOllamaから実行しました。
ローカルLLMを始めようとすると、「どのくらい高いMacが必要なのか」が分かりにくいです。最新で高価なMacを買えば安心ではありますが、用途によってはそこまで必要ない場合もあります。反対に、大きなモデルや長いコンテキストを扱うなら、より上位の構成が必要になることもあります。
この記事では、M2 Pro Mac mini 32GBで実際にQwen3 8B / 14Bを動かした結果をもとに、自分の用途ではどこまで使えたかを整理します。結論から言うと、普段使いでは8Bがかなり快適で、14Bも必要に応じて使える速度でした。
Ollamaの基本はOllamaとは?初心者向けにできること・仕組み・始め方を解説で、Qwen3の導入手順はMacでQwen3を動かす方法で説明しています。
この記事は手元のM2 Pro Mac mini 32GBでの実測記録です。発熱、消費電力、騒音、回答品質、長時間運用の安定性は測定していません。OS全体の使用済みメモリを、モデル単体のRAM使用量としては扱いません。
検証環境
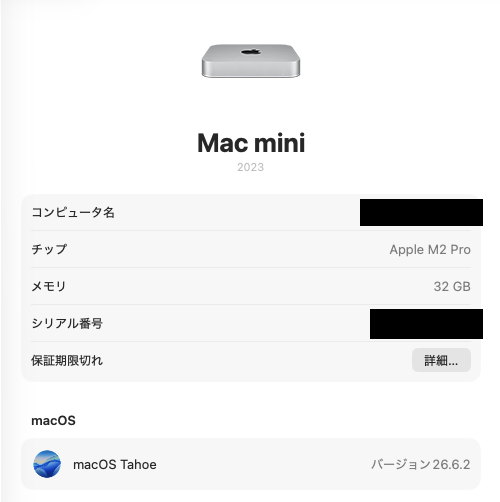
今回使ったMac miniは次の構成です。
| 項目 | 内容 |
|---|---|
| Mac | Mac mini 2023 |
| チップ | Apple M2 Pro |
| メモリ | 32GB |
| ストレージ | 約1TB |
| 実行環境 | Ollama |
| モデル | Qwen3 8B / Qwen3 14B |
測定では、同じ日本語プロンプトを使いました。
畳の張り替え時期について、一般の人向けに300文字程度で分かりやすく説明してください。Contextは32768で確認しました。GPU使用率、Swap、Ollama上のモデル表示サイズなど、画面で確認できた値を中心に扱います。

Qwen3 8Bを実測
まずQwen3 8Bです。
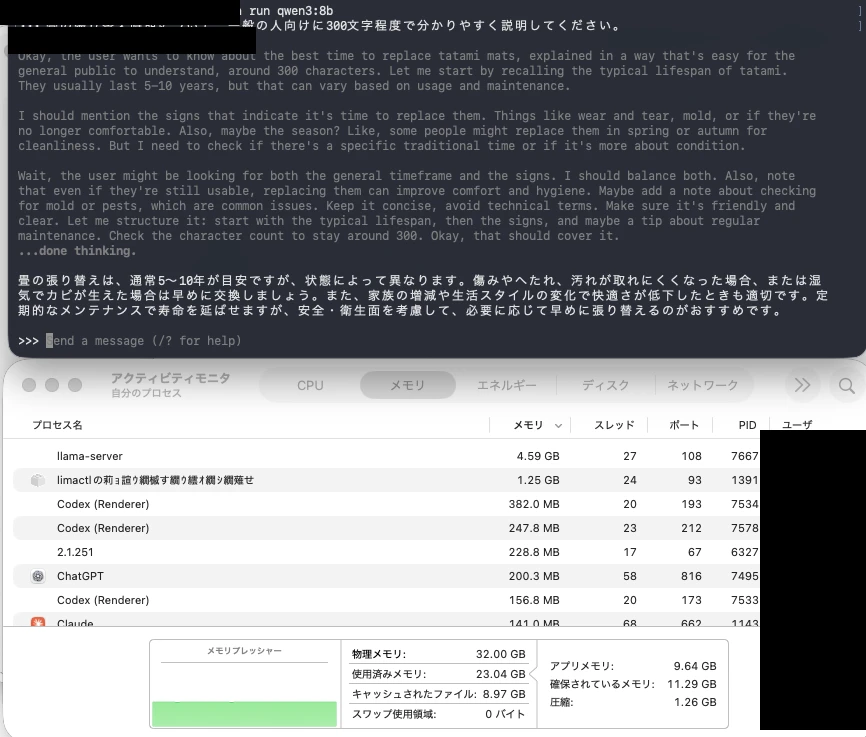
今回の測定では、Ollama上の表示サイズは10GB、生成速度は約31.5 tok/sでした。GPUは100%まで使われ、Swapは0でした。
8Bは、短い相談や文章の下書き、要約、ちょっとした調べものの整理に使いやすい印象です。返答を待つ時間が短く、iPhoneからSSHで使う場合でも、コマンド実行後の反応に大きな待ち時間を感じにくい速度でした。
ただし、これは回答品質まで評価した結果ではありません。専門的な内容の正確さや、長い文章を渡したときの安定性は別に見る必要があります。
Qwen3 14Bを実測
次にQwen3 14Bです。
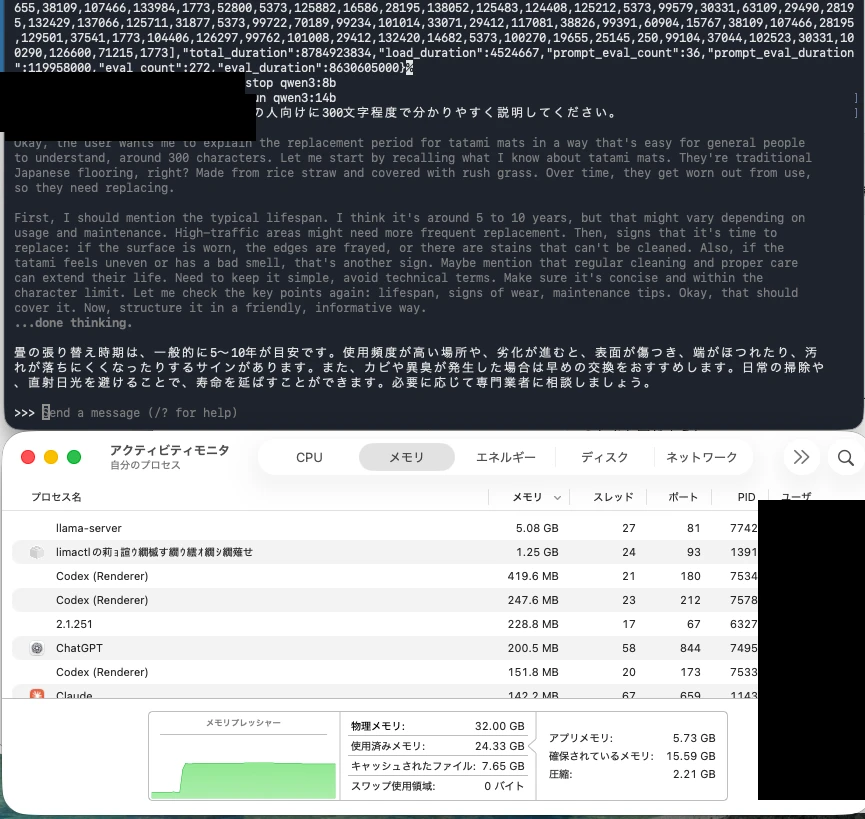
今回の測定では、Ollama上の表示サイズは14GB、生成速度は約14.8 tok/sでした。こちらもGPUは100%まで使われ、Swapは0でした。
14Bは8Bより返答を待つ時間が長くなります。それでも、短い質問や文章作成の範囲では実用可能な速度でした。普段から常に14Bを使うというより、少し重めの相談をしたいときに切り替える使い方が合っています。
ここでも、OS全体の使用済みメモリをモデル単体の消費メモリとは見なしません。今回断定できるのは、Ollamaの表示サイズ、GPU 100%、Context 32768、Swap 0、生成速度です。
8Bと14Bを比較
今回の結果を並べると次のようになります。
| モデル | ollama ps 表示サイズ(Context 32768) | 生成速度 | GPU | Swap |
|---|---|---|---|---|
| Qwen3 8B | 10GB | 約31.5 tok/s | 100% | 0 |
| Qwen3 14B | 14GB | 約14.8 tok/s | 100% | 0 |
10GB / 14GBは今回のロード時に確認した表示値で、Ollama公式ライブラリ上のモデルファイル容量とは別の値です。
体感としては、8Bは普段使い向きです。チャット、下書き、要約、アイデア出しのような用途では、速度面で扱いやすいです。
14Bは、8Bより重くなります。その分、少し大きなモデルを試したいときの選択肢になります。自分の運用では、普段は8Bを選び、必要に応じて14Bへ切り替える形が合っています。
この比較は、M2 Pro Mac mini 32GB上での実測です。
iPhoneからMac miniのQwen3を使う
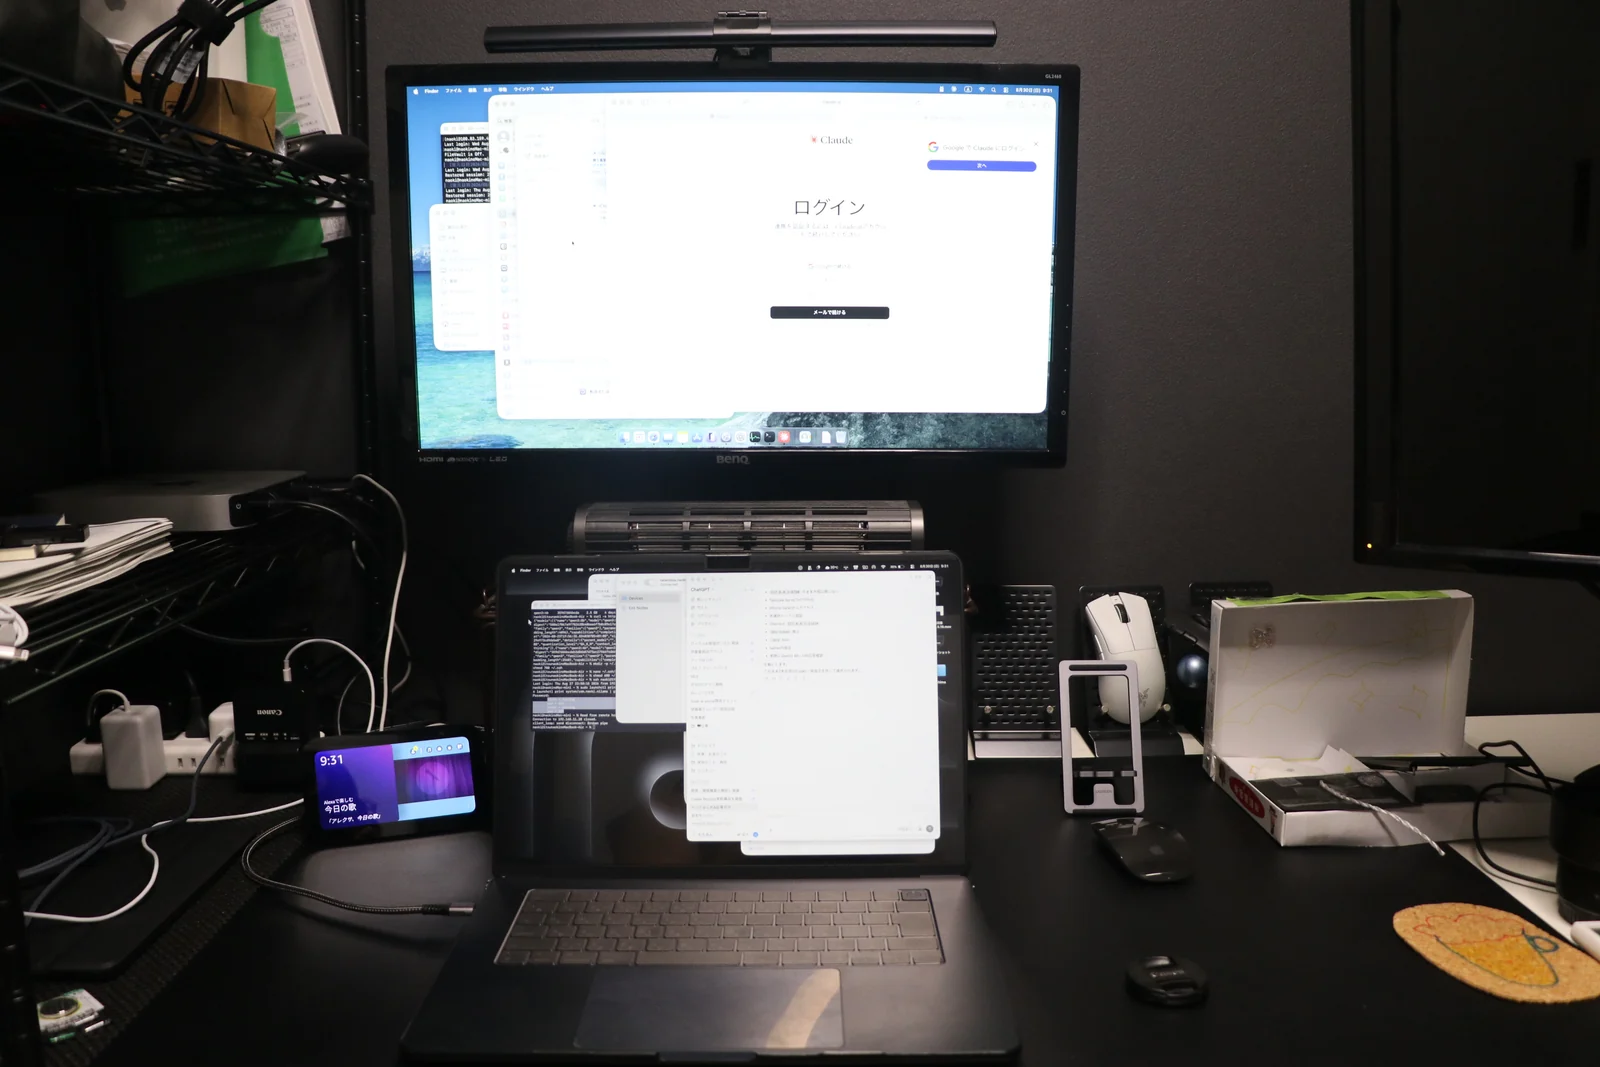
このMac miniは机の上で直接操作するだけでなく、自宅サーバーとして置きっぱなしにしています。
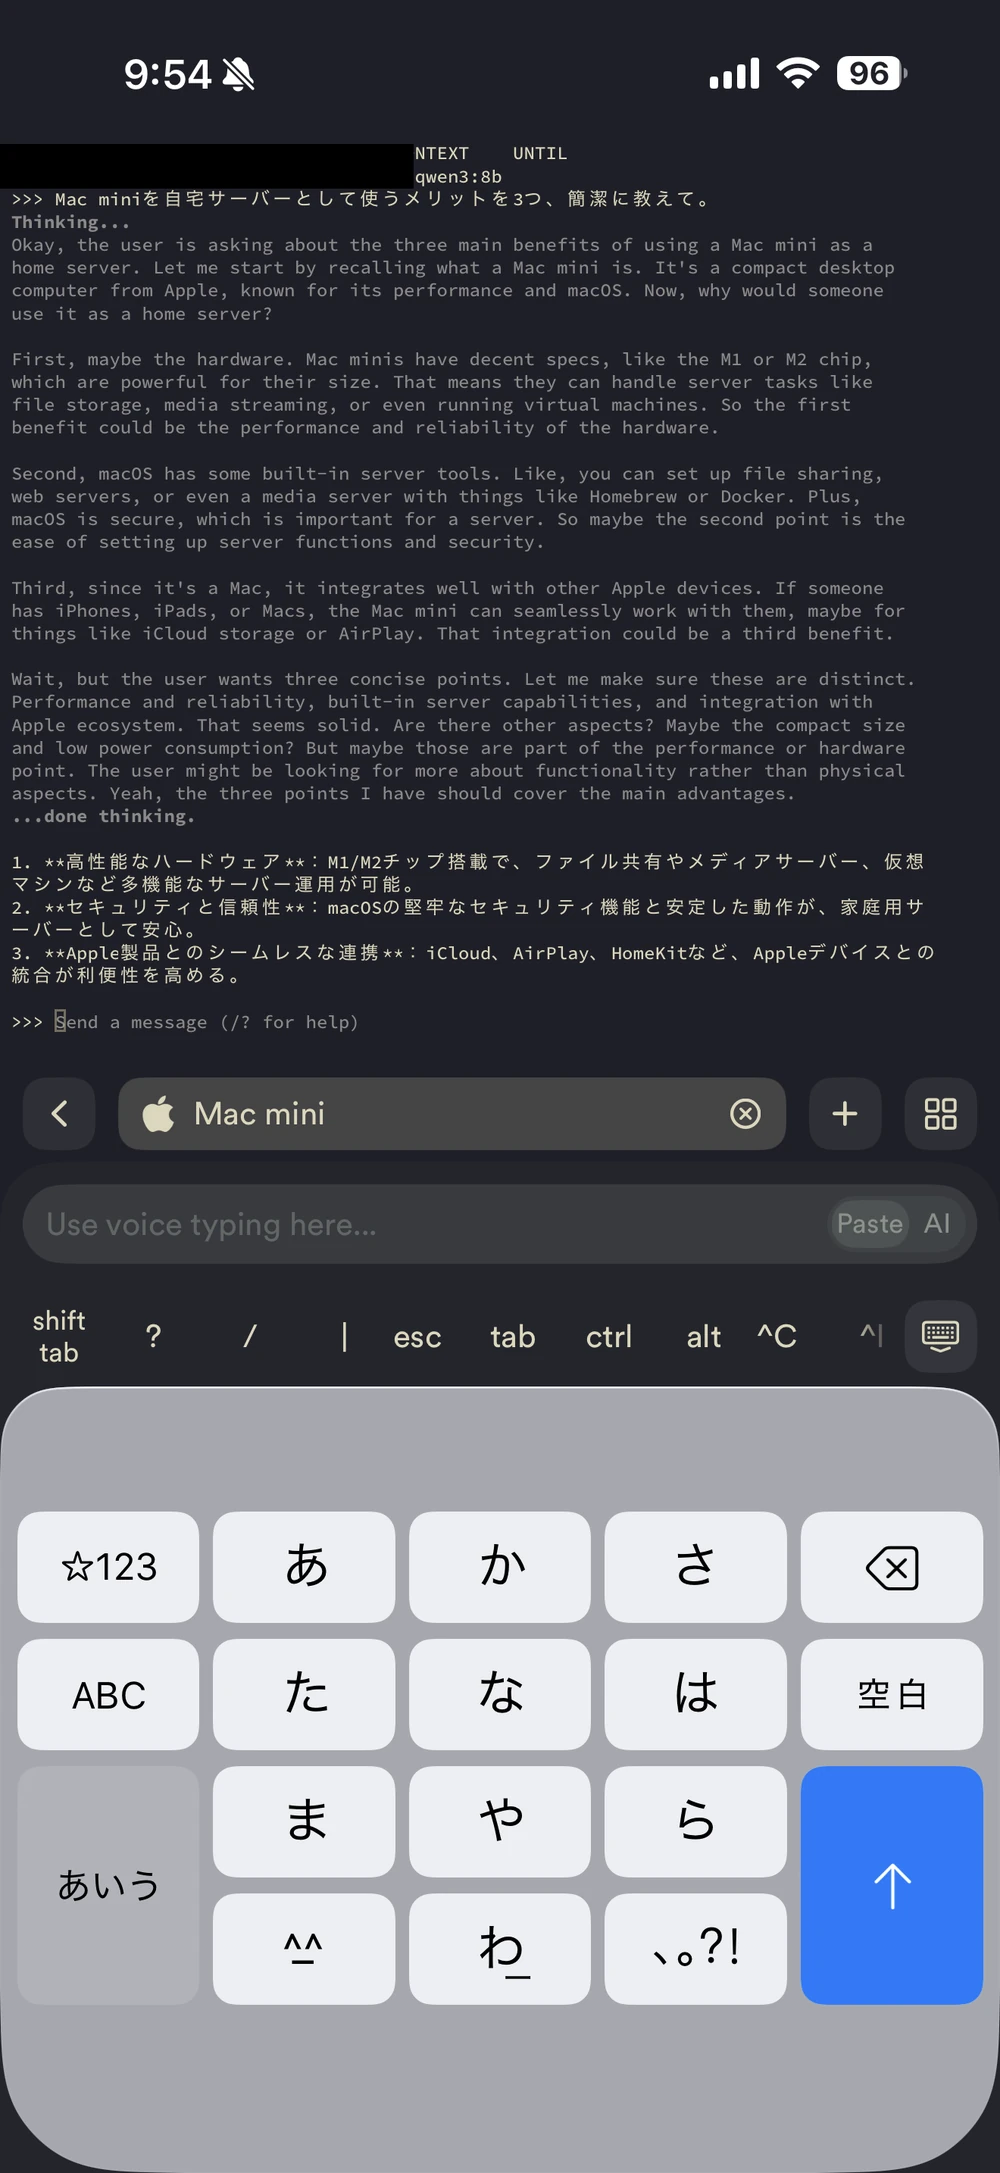
iPhoneからはTermiusでMac miniへSSH接続し、次のようにQwen3 8Bを起動して使っています。
ollama run qwen3:8bMac mini側でOllamaが動いていれば、iPhoneは入力端末として使えます。ローカルLLM自体はMac mini上で動き、iPhoneからはSSH越しに操作する形です。
この使い方は、外出先でネット接続なしにローカルLLMを使う用途とは違います。持ち運んでオフラインで使いたいならMacBookが向いています。一方で、自宅にMac miniを置き、iPhoneやMacBookから遠隔操作する運用なら、据え置き機でも十分に活用できます。
Mac miniを自宅サーバーとしてどう運用しているかは、M2 Pro Mac miniを自宅サーバー化してiPhoneから遠隔管理する環境にまとめています。
ローカルLLMにハイスペック機は必要?
今回の範囲では、自分の用途にはM2 Pro Mac mini 32GBで十分でした。
8Bはかなり快適に使えました。14Bも、短いチャットや文章作成では実用可能でした。Swapが0だった点も、今回の測定条件では安心材料です。
ただし、「ローカルLLMにハイスペック機は不要」と断定するつもりはありません。用途によって必要なスペックは大きく変わります。
大事なのは、スペックを高くすれば必ず満足できる、という考え方だけで選ばないことです。どのモデルを使うのか、どのくらいの長さの文章を扱うのか、同時に何を動かすのかから逆算した方が失敗しにくいです。
ハイスペック機が必要になるケース
より上位のMacや大容量メモリが活きる場面もあります。
- 30B、70B級などの大規模モデルを使う
- 長大なコンテキストを扱う
- 複数人で同時利用する
- 大規模コードベースをローカルAIで扱う
- Visionや画像生成もローカルで行う
- LoRAなどの学習やモデル調整を行う
- 大型モデルでも高速レスポンスを求める
こうした用途では、M2 Pro 32GBだけで十分とは言い切れません。メモリ容量、GPU性能、ストレージ、冷却、運用時間まで含めて考える必要があります。
逆に、8B中心で個人利用するなら、最初から最上位構成を前提にしなくてもよい可能性があります。まず使いたいモデルと用途を決め、その上でMacの構成を選ぶのが現実的です。
Mac miniをローカルAI+自宅サーバーとして使う
自分の場合、Mac miniはローカルLLM専用機ではありません。
現在は次のような用途にも使っています。
- Ollama
- Qwen3
- Tailscale
- SSH
- Mac mini管理ポータル
- ブラウザターミナル
- ファイル管理
- 自動バックアップ
- Docker系サービス
- Portainer
- Uptime Kuma
ローカルLLMだけなら、ノートMacで十分な人もいます。自分の場合は、据え置きで常時稼働させ、iPhoneから管理し、バックアップやDockerもまとめて扱えることに価値がありました。
Mac miniの設置環境や遠隔管理の構成は、別記事のMac mini自宅サーバー運用記事で整理しています。
まとめ
M2 Pro Mac mini 32GBでQwen3 8Bと14Bを実測しました。
今回の結果では、Qwen3 8Bは約31.5 tok/sで、普段使いしやすい速度でした。Qwen3 14Bは約14.8 tok/sで、8Bより待ち時間は増えるものの、短いチャットや文章作成では実用可能でした。どちらも今回の測定ではGPU 100%、Swap 0でした。
この結果だけで、ローカルLLMにハイスペック機は不要とは言えません。大規模モデル、長大なコンテキスト、複数人利用、Vision、学習用途では、より高いスペックが必要になる場合があります。
自分の使い方では、M2 Pro Mac mini 32GBを「普段は8B、必要に応じて14B」という形で使うのが合っていました。スペックは高いほど正義と考えるより、使いたいモデルと運用方法から逆算する方が選びやすいです。